Bare-metal: Kubernetes, 3 Dell R710 et une facture EDF
J'ai deployé un lab sur 3 vieux Dell R710. Ca m'a appris Kubernetes, iDRAC, le bruit, la chaleur et ce que le cloud facture quand il vous évite tout ça.
Ce n'est pas tous les jours qu'on apprend que son conjoint vient de commander un rack serveur et 80Kg de matériel informatique sur eBay.
La lune de miel
Pourtant, c'est la nouvelle qu'a reçue ma compagne début 2023. Après une courte explication sur mes intentions, ainsi que sur le bruit potentiel que pouvait générer un tel projet, elle m'a fortement conseillé de garder le problème, le bruit et la chaleur bien au fond de mon bureau.
À réception, j'ai inspecté le tout et, n'ayant jamais mis les mains dans ce genre de machine, j'avais l'impression de découvrir un nouveau monde: le hardware d'entreprise . Première chose qui saute aux yeux: ne parlez pas d'ATX à Dell, le format de la carte mère est alien ici ; Adieu l'extensibilité et la capacité d'upgrade qu'on peut attendre du consumer hardware . Ici, Dell propose un package prévu pour une génération, et une génération seulement.
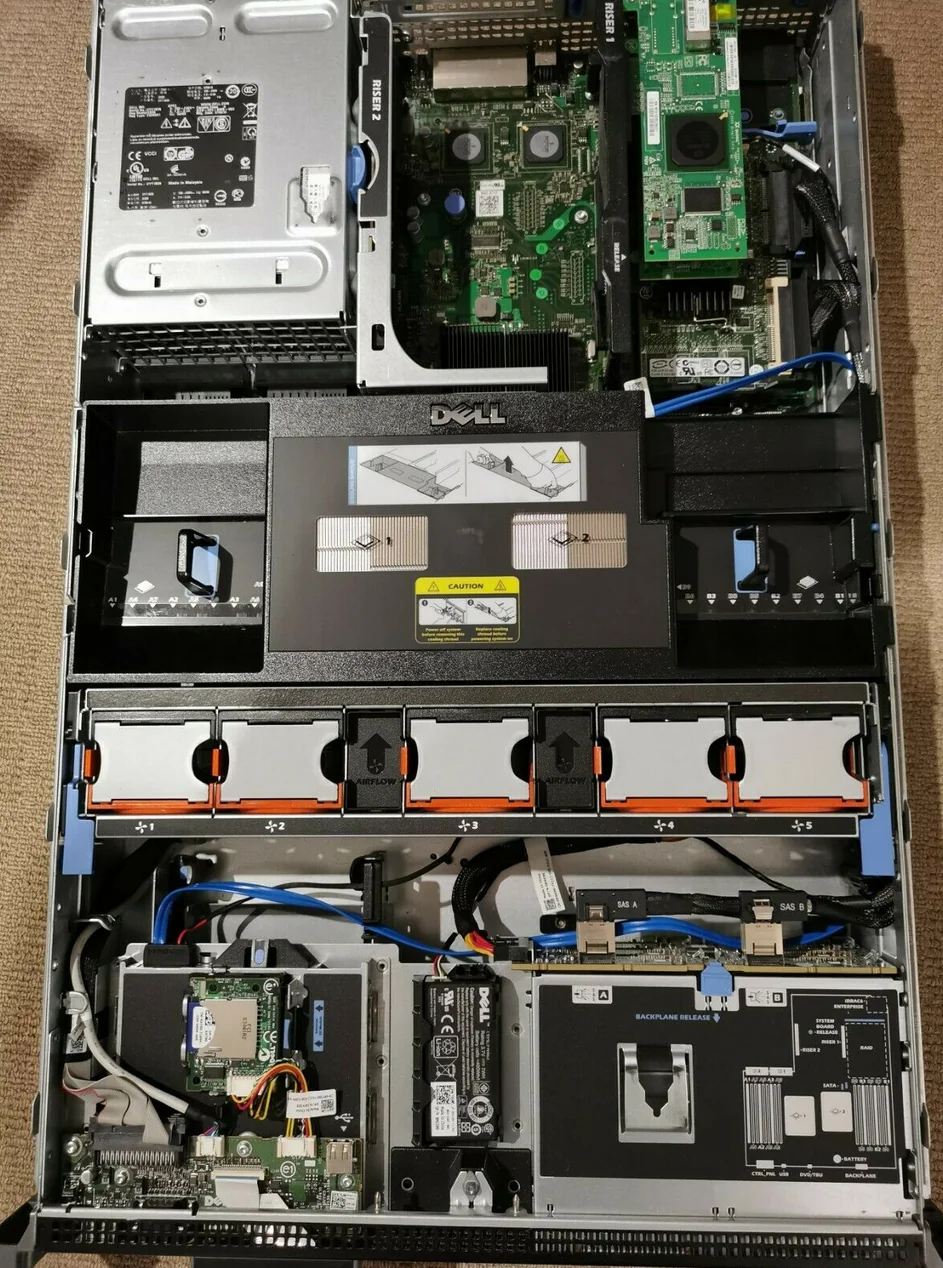
Deuxième chose, et plutôt impressionnante: la facilité avec laquelle on peut inspecter, ajouter ou enlever les différents composants. Partant de mon expérience avec des PC ou des laptops, je pensais avoir besoin d'un kit complet de tournevis et de pinces, avant de réaliser que tout est fait pour ne jamais avoir besoin d'outils pour manipuler le cœur de ces machines.
- Le capot est aussi simple à ouvrir que celui d'une Peugeot 206.
- Le radiateur CPU s'enlève avec la simple force de mes deux mains de primate.
- Les disques durs sont aussi faciles à changer qu'une ampoule.
C'est assez cohérent quand on y pense: dans un data center, l'intervention sur ces machines est critique et doit durer le moins de temps possible. La facilité avec laquelle j'ai pu initialement bidouiller et intervenir sur ces machines ne vient pas nécessairement d'une intention d'aider les novices (bien que ça aide) mais plutôt de garantir une continuité de service optimale.
Le démarrage du réacteur
Bon, allez, assez parlé, démarrons l'engin. Je branche, j'appuie sur le bouton « power » et, soudain, j'entends un Dassault Rafale décoller, faire trois loopings et activer ses afterburners, tout ça dans mon bureau. Alors oui, je m'attendais à du bruit, mais quatre ventilos à 8 000 tours/minute, c'est plus que du bruit. Bon, j'éteins et je demande à Google comment préserver mon audition. Voici sa réponse :
ipmitool -U <user name> -P <password> -H <hostname> raw 0x30 0x70 0x66 0x01 0x00 0x<01 - 64>Super, mais attends ? Comment ça, il faut un hostname ? Un username ? Un password ? J'ai assez vite compris une autre facette de ces machines: elles sont faites pour être gérées à distance, et pas forcément par des amateurs. Après quelques recherches, je trouve la solution: je connecte un câble Ethernet à la carte iDRAC, je configure une adresse IP statique, j'exécute la commande depuis mon laptop et la magie opère. Les ventilos ralentissent, le bruit devient supportable, et mes chats peuvent enfin sortir de leur cachette.
Maintenant que le bruit est sous contrôle, accédons au système. Je branche un vieux écran, puis j'arrive sur l'interface de login d'un Windows Server 2000-je-ne-sais-pas-trop-quoi. Ouais bon, on ne va pas perdre de temps: on va installer Debian. J'installe, je configure le système, je redémarre et hourra ! J'arrive sur un bon vieux terminal Unix. Je me connecte, je peux voir les disques, les cartes réseau, les températures, les ventilateurs: tout est là.
Faire du neuf avec du vieux
Après avoir répliqué la même opération sur les trois machines, arrive le moment de faire tourner Kubernetes. Partant d'une humble expérience avec AKS et Minikube, je me lance dans l'installation de K3s, puis je déploie Rancher, Cert-Manager, Traefik et toute la panoplie de charts Helm dont j'ai la flemme d'expliquer l'utilité. Tout se passe sans encombre et, hormis quelques ajustements de configuration pour les ressources, le cluster tourne. Je peux déployer des applications, faire du port-forwarding, du monitoring, du logging, bref, tout ce que j'attends d'un cluster Kubernetes.
C'est assez impressionnant de voir ça tourner sur du vieux hardware. Bien sûr, il y a des limitations: les performances ne sont pas folles, le stockage local est turbo-lent et la consommation électrique abyssale. Mais c'est aussi ça qui rend l'expérience intéressante: on apprend à faire du neuf avec du vieux, à optimiser les ressources, à gérer les contraintes et à comprendre ce qui se passe sous le capot.
Ce que le métal rend visible
On avance de quelques mois dans le temps et le cluster tourne toujours, mais pas sans encombre. Et c'est là que le métal rend les choses visibles. Le cloud n'est pas magique: il mutualise la maintenance et les problèmes qu'on rencontre très vite quand on veut faire les choses sérieusement.
Le premier problème qui se pose est celui de la supervision. Sans quelque chose pour savoir ce qu'il se passe, le cluster devient une boîte noire qui chauffe la pièce et reçoit occasionnellement des requêtes HTTP. Ce n'est pas forcément glamour, mais c'est indispensable pour maintenir le cluster en vie. À la rescousse: Prometheus, Grafana, Alertmanager, Node Exporter, etc. Avec ça, j'ai accès, via une simple interface web, à des métriques en temps réel sur la température des machines, la pression mémoire, la saturation des disques, les erreurs réseau, etc.
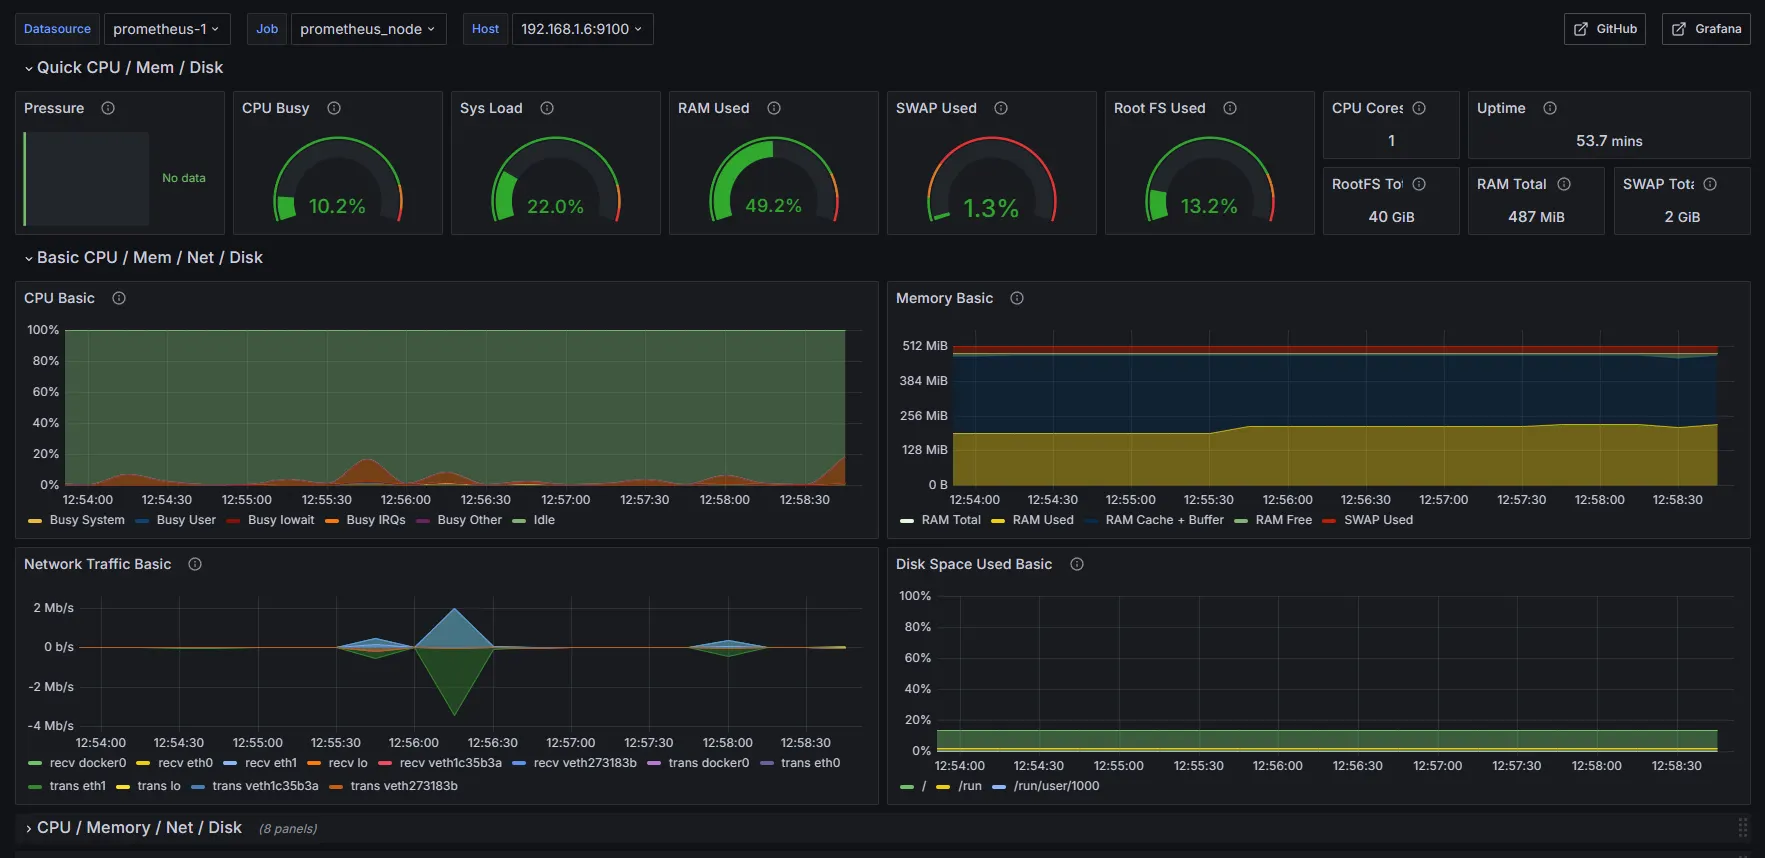
Ok, cool. On peut maintenant voir ce qui se passe, mais ça ne résout pas les problèmes: ça les rend visibles. Les disques saturent car ils sont lents, les machines redémarrent car elles chauffent, le réseau est instable et les systèmes sont inondés de logs d'erreur. C'est là que le travail commence: on apprend à lire les métriques, à comprendre les alertes, à faire du tri dans les logs, à redémarrer les machines, à remplacer les disques, à ajuster les configurations, bref, à faire du bare-metal.
Pour autant, quand une machine ne répond plus, l'abstraction tombe vite. On revient à la console, au boot order, aux logs matériels, aux alimentations, aux disques, aux températures. Cette partie n'est pas belle non plus, mais elle change la manière de concevoir une plateforme. Après quelques soirées à remettre un node dans le cluster, on écrit des runbooks plus courts. On arrête de confondre « déployé » et « opérable ». On respecte beaucoup plus les métriques qui préviennent avant l'incident.
On ne va pas rentrer dans le détail de toutes les solutions que j'ai dû mettre en place, mais pour faire très bref: script de contrôle des ventilos, ajout de RAM, remplacement des disques par des SSD et des NVMe, ajout de cartes réseau PCI, upgrade du routeur en 10 Gbit/s, nouvelles cartes RAID, installation de CephFS puis de Longhorn par la suite (ne me parlez plus jamais de CephFS) upgrade kernel, configuration des backups, le tout avec une bonne dose de patience et l'aide inestimable d'Ansible puis de Terraform.
Ce que le cloud permet d'oublier
Dans cette épopée, on se rend compte que les serveurs ont une personnalité, et que, comme nous, ils sont à la ramasse s'ils n'ont pas pris leur café du matin. Le cloud n'est pas magique: il est fonctionnel parce qu'il est maintenu par des gens qui font un travail exceptionnel de maintenance, de support et d'amélioration continue. Le cloud permet d'oublier les détails du hardware, de la configuration, de la maintenance, de la recovery, et de se concentrer sur le développement.
On se rend compte que les providers cloud ne vendent pas seulement des VM et du compute. Ils vendent aussi l'oubli de certaines réalités: les disques qui tombent en panne, les machines qui ne bootent plus, la configuration réseau qui déconne, les drivers incompatibles, les mises à jour qui cassent tout, les incidents qui arrivent sans prévenir, la segmentation réseau.
Sans parler de la facture EDF qui arrive tous les mois et qui rappelle pourquoi chaque nouvelle génération de processeurs Intel ou AMD passe autant de temps à optimiser la consommation électrique. La facture est une métrique d'observabilité: elle ne vous dira pas quel pod est gourmand, mais elle vous rappellera que toute mauvaise idée a une consommation réelle.
Du coup, qu'est-ce qu'on retient de tout ça ?
Le cloud est une bonne réponse à un vrai problème. Gérer du hardware, c'est un métier à part entière, et déléguer ça à des gens qui font ça mieux que nous est souvent la décision la plus raisonnable.
Mais le cloud a aussi ses opinions, et ces opinions ont un but commercial. Quand AWS, Azure ou GCP nous proposent un service managé pour chaque couche d'une stack, c'est pratique. C'est aussi une façon de rendre chaque migration un peu plus douloureuse, chaque ligne de code un peu plus propriétaire, chaque facture un peu plus difficile à justifier à un DAF qui découvre ce que signifie "egress fees".
Ce que trois Dell R710 et quelques soirées à genoux devant un terminal m'ont appris, c'est surtout ça: comprendre ce que le cloud abstrait, c'est comprendre ce pour quoi on paie vraiment. C'est aussi distinguer les couches pour lesquelles on a intérêt à payer quelqu'un afin d'oublier la redondance électrique, les disques qui tombent en panne à 3 h du matin et le réseau physique, de celles où on peut s'en sortir avec une solution open source bien choisie et un déploiement propre.
Le bare-metal ne remplace pas le cloud. Mais il remet les pieds sur terre. Et les pieds sur terre, ça change la façon dont on lit une architecture, dont on signe un contrat, et dont on répond à « pourquoi pas juste un Lambda ? » en réunion.